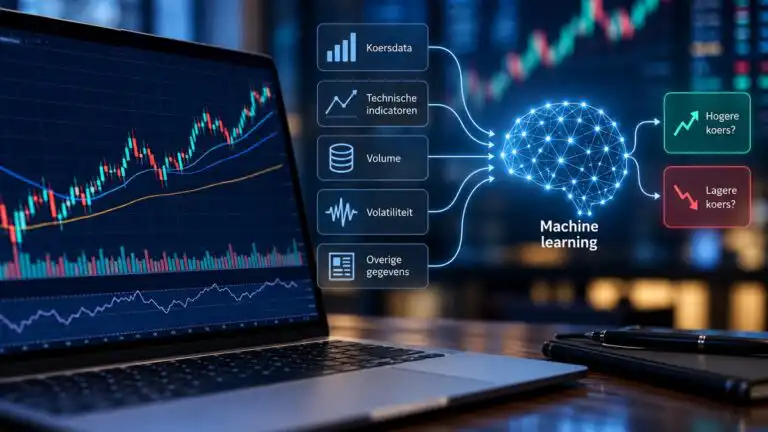
Machine learning bij beleggen betekent dat een computer op basis van voorbeelden uit historische marktdata zelf statistische verbanden leert. Het model krijgt dus niet alleen vooraf vastgelegde handelsregels, maar schat uit gegevens welke patronen bruikbaar kunnen zijn voor een bepaalde taak. Dat kan bijvoorbeeld het herkennen van een marktregime zijn of het berekenen van de kans op een stijgende of dalende koersbeweging.
Dat woord ‘leren’ kan gemakkelijk te veel suggereren. Een model begrijpt de beurs niet zoals een mens dat doet en weet niet waarom een koers morgen zal stijgen of dalen. Het berekent relaties in data. De kwaliteit van de uitkomst hangt daarom sterk af van de gekozen gegevens, het doel waarop het model wordt getraind en de manier waarop het daarna wordt getest.
Wat machine learning anders maakt dan vaste handelsregels
Een klassiek algoritme kan volledig uit handmatig gekozen regels bestaan. Denk aan een systeem dat een signaal geeft zodra twee voortschrijdende gemiddelden elkaar kruisen. De programmeur bepaalt dan vooraf exact welke voorwaarden gelden.
Bij machine learning ligt een deel van die keuze in het model. De ontwikkelaar bepaalt nog steeds welke gegevens worden gebruikt, welke uitkomst moet worden voorspeld en welk type model wordt toegepast, maar het model zoekt binnen die opzet zelf naar statistische relaties. Daardoor kan het combinaties vinden die niet eenvoudig in één vaste regel zijn samen te vatten.
Dat maakt machine learning niet automatisch beter. Een eenvoudige regel kan robuuster en beter uitlegbaar zijn dan een complex model. Meer rekenkracht of meer variabelen leveren alleen voordeel op wanneer de gevonden relaties ook buiten de trainingsperiode standhouden.
Hoe werkt machine learning bij beleggen?
Een machine-learningmodel begint met een duidelijk omschreven vraag. Zonder zo’n vraag is er niets zinnigs om te trainen. Vervolgens worden historische gegevens verzameld en omgezet in invoervariabelen die het model kan verwerken.
Features: welke informatie krijgt het model?
De invoervariabelen worden vaak features genoemd. Bij marktdata kunnen dat bijvoorbeeld rendementen over eerdere dagen, volatiliteit, handelsvolume, momentum of waarden van technische indicatoren zijn. Ook combinaties van zulke gegevens zijn mogelijk.
Belangrijk is dat iedere feature beschikbaar moet zijn op het moment waarop het model in de praktijk een beslissing zou nemen. Als tijdens het trainen per ongeluk informatie wordt gebruikt die pas later bekend werd, ontstaat datalekkage. Het model lijkt dan achteraf slimmer dan het in werkelijkheid kan zijn.
Target: wat probeert het model te voorspellen?
Naast de invoer is een target nodig: de uitkomst die het model probeert te leren. Dat kan bijvoorbeeld zijn of een index de volgende handelsdag hoger of lager sluit, hoe hoog de volatiliteit in een komende periode wordt of tot welk marktregime een situatie behoort.
De keuze van het target bepaalt wat de uitkomst betekent. Een model dat een kans op een hogere slotkoers berekent, geeft nog niet automatisch een compleet handelssignaal. Zaken als transactiekosten, risicolimieten, positiegrootte en de regels voor openen of sluiten van een positie staan daar los van.
Trainen en testen moeten in de juiste tijdsvolgorde gebeuren
Een model beoordelen op dezelfde gegevens waarmee het is getraind zegt weinig over de bruikbaarheid op nieuwe marktdata. Daarom wordt historische data doorgaans verdeeld in verschillende perioden. Een ouder deel kan worden gebruikt om het model te trainen, een later deel om keuzes te valideren en een nog niet gebruikte periode om te testen hoe het model buiten de trainingsdata presteert.
Bij financiële tijdreeksen is de volgorde belangrijk. Je kunt toekomstige beursinformatie niet willekeurig mengen met oudere waarnemingen alsof alle voorbeelden onafhankelijk van de tijd zijn. Ook mag een testperiode niet steeds opnieuw worden gebruikt om het model bij te stellen, want dan wordt die testperiode feitelijk onderdeel van het ontwikkelproces.
Daarom is een backtest van een tradingstrategie vooral waardevol wanneer vooraf duidelijk is welke regels worden getest en wanneer de beoordeling plaatsvindt op gegevens die niet voor het afstellen van het model zijn gebruikt.
Van koersdata naar een modeluitkomst: een eenvoudig voorbeeld
Stel dat een model moet inschatten of een beursindex de volgende handelsdag hoger of lager sluit. Als invoer krijgt het onder meer het rendement van de afgelopen dagen, recente volatiliteit, momentum en het handelsvolume ten opzichte van een voortschrijdend gemiddelde.
Tijdens de trainingsfase ziet het model veel historische situaties met daarbij de latere uitkomst. Op basis daarvan worden de modelparameters aangepast. Wanneer daarna nieuwe marktgegevens binnenkomen, kan het model bijvoorbeeld een kansscore berekenen voor een stijgende of dalende volgende handelsdag.
Zo’n kansscore moet zorgvuldig worden geïnterpreteerd. Een uitkomst van bijvoorbeeld 56 procent is geen zekerheid en ook niet vanzelf een reden om te handelen. De praktische betekenis hangt af van de betrouwbaarheid van het model, de gekozen drempel voor een signaal, kosten, risico en de vraag of de historische relatie nog relevant is.
Waarom sterke historische resultaten toch kunnen tegenvallen
Een bekend gevaar is overfitting. Het model leert dan niet alleen een werkelijk bruikbaar patroon, maar ook toevalligheden en ruis uit de trainingsdata. Op de historische gegevens kan het resultaat indrukwekkend lijken, terwijl de prestaties op nieuwe data sterk terugvallen.
Daarnaast veranderen financiële markten. Rente, liquiditeit, volatiliteit, regelgeving, marktstructuur en gedrag van beleggers kunnen ervoor zorgen dat een verband dat in de ene periode werkte later zwakker wordt of verdwijnt. Machine learning is bovendien maar één techniek binnen het bredere terrein van AI trading, waarin algoritmes en modellen marktgegevens systematisch kunnen verwerken en de uitkomst bijvoorbeeld in een signaal kunnen vertalen.
Juist daarom moet een model niet alleen op nauwkeurigheid worden beoordeeld. Ook stabiliteit in verschillende perioden, gevoeligheid voor kleine wijzigingen, transactiekosten en het verschil tussen trainingsresultaten en resultaten op ongeziene data zijn belangrijk.
Welke claims over machine learning verdienen extra aandacht?
Complexe modellen kunnen een professionele indruk wekken, maar technische complexiteit is geen bewijs van betrouwbaarheid. Bij een systeem of onderzoek waarin machine learning wordt gebruikt, zijn vooral de onderliggende aannames relevant.
Vier vragen helpen om zulke claims te beoordelen:
- Welke gegevens zijn gebruikt en waren die op het beslismoment werkelijk beschikbaar?
- Wat voorspelt het model precies, en hoe wordt die uitkomst vertaald naar een handelsbeslissing?
- Is het resultaat ook getest op een afzonderlijke, ongeziene periode?
- Zijn kosten, veranderende marktomstandigheden en mogelijke modelfouten meegenomen?
Ook toezichthouders wijzen op deze risico’s. ESMA noemt bij het gebruik van AI in beleggingsdiensten onder meer datakwaliteit, algoritmische vertekening en te grote afhankelijkheid van AI als aandachtspunten. Die waarschuwing richt zich op beleggingsondernemingen, maar de onderliggende boodschap is breder bruikbaar: een modeluitkomst is slechts zo betrouwbaar als de data, aannames en controles erachter.
Wat heeft een belegger praktisch aan machine learning?
De grootste praktische waarde van machine learning ligt niet in het beloven van een voorspelbare beurs, maar in het systematisch analyseren van veel gegevens volgens een vaste methode. Een model kan dezelfde invoer telkens op dezelfde manier verwerken, meerdere variabelen tegelijk beoordelen en een probabilistische uitkomst geven zonder dat stemming of emotie de berekening verandert.
Voor een belegger is vervolgens vooral van belang wat die uitkomst betekent en hoe betrouwbaar die buiten de trainingsdata is. Een systeem waarbij duidelijk is welke data worden gebruikt, wat het model probeert te voorspellen en hoe het is gevalideerd, is beter te beoordelen dan een systeem dat alleen een hoog historisch rendement of een indrukwekkend AI-label toont.
De belangrijkste beperking blijft dat machine learning relaties uit het verleden gebruikt om nieuwe situaties te beoordelen. Zelfs een zorgvuldig getest model kan niet garanderen dat dezelfde relaties onder toekomstige marktomstandigheden blijven bestaan. Historische modelprestaties zijn daarom bewijs over een testperiode, geen zekerheid over een volgende beursdag.